
¿Es correcto el término riñonera o debería ser pulmonera? ¿Cómo la usáis?
 Open web. Clear feed.

Digital Nomad. Developer, Conversational AI, NLP.
¿Es correcto el término riñonera o debería ser pulmonera? ¿Cómo la usáis?
Hoy @NexusSites ha publicado esto: nexusmods.com/news/15654 Que en principio no me parece mal, peeeeeeeeeeeeero: "We are pro-human creativity" <= te vas a su repo y descubres que están usando Claude, pero no cumplen sus propias reglas y no avisan de que su código es AI-Generated
La Federación Portuguesa no se la ha querido jugar a quedarse sin RAM con la multa de Cristiano Ronaldo, así que ha sido de 255€ para que quepa en 1 único byte. 256€ habrían sido 2 bytes y ya sería excesivo.
En definitiva, en Node.js se puede optimizar mucho la performance de lo que hay, pero el problema es que se usan librerías que usan librerías que usan librerías... y en esa cadena trófica alguna no estará optimizada.
También decidí echar un ojo a jsonwebtoken, y hacer una implementación paralela, se mejora el sign y el verify de HS256 en casi 5 veces más rápido!

Una de las causas por las que se mejoran tiempos en mongodb es por el serialize y deserialize de BSON, cambiando la librería por defecto se logran tiempos muchísimo mejores.

Lo mismo para mongo, aunque me queda de asignatura pendiente mejorar el aggregate y el updateMany
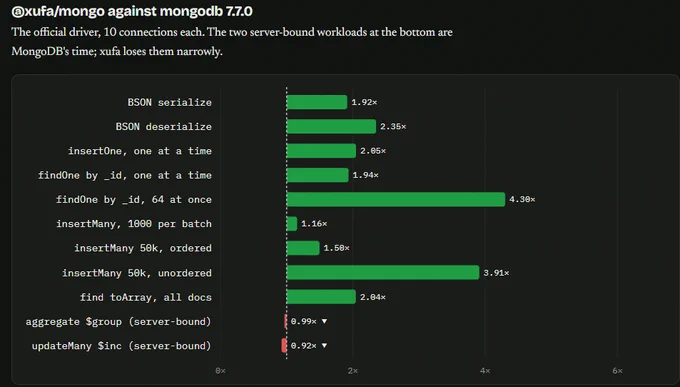
Lo más interesante: la gente confía en que las librerías de mongo o postgre tengan la mejor performance. Pues he descubierto que no necesariamente, por ejemplo implementando pg desde cero se mejora su perf

Y llegamos a la parte de base de datos. El ORM es una parte crucial, si el ORM va lento, va a ser un factor limitante en la cantidad de req/s que vas a poder servir, así que me comparé con sequelize, e incluso hice un interfaz compatible con él, y lo comparé con postgres y sqlite

Mucha gente usa ajv porque es rápido y muy completo , pero sí es cierto que se puede mejorar la performance de ajv e incluso lograr que cubra más especificaciones de los drafts de json schema


Una de las cosas que encontré fue que las route lookups con find-my-way no están muy optimizadas, y se consigue ir el doble de rápido en static con otra implementación

Para hacerlo me marqué el objetivo de 0 dependencias, así que hice mi propia implementación del server y la comparé con Fastify. Se consiguen mejores tiempos

La latencia también cambia mucho, por ejemplo editar un autor baja de 104ms en Django a 11ms en Node en el p50, de 216ms a 25ms en el p90


Es como mínimo 8.5 veces más rápida en node la implementación del mismo ejemplo. Lo comparé con diferentes servers de Python

He estado haciendo una framework de Node.js que fuese similar a Django. Lo curioso es que por el camino he descubierto que se puede mejorar la performance de muchas librerías de Node.js existentes. Empecemos por su performance vs la de Django, usando el ejemplo LocalLibrary🧵

A un hombre se le regala BERSERK. Síganme para más consejos.

❌ Regalos que JAMÁS se le hacen a un hombre: ・Ropa para cambiar su estilo 👔 (invalidas su gusto) ・Mascota sorpresa 🐕 (carga financiera) ・Adornos genéricos 🖼️ (basura inútil) ・Calzoncillos 🩲 (no es un niño) ・Colonia barata 🧴 (cero esfuerzo) ✅ Lo que SÍ funciona ↓↓
